> ## Documentation Index
> Fetch the complete documentation index at: https://notes.kodekloud.com/llms.txt
> Use this file to discover all available pages before exploring further.
# Monitoring Cluster Components
> Guide to monitoring Kubernetes clusters, covering metrics to collect, metrics flow, Metrics Server usage and deployment, and when to use Prometheus or commercial monitoring solutions
This lesson covers how to monitor a Kubernetes cluster: what to collect, how metrics flow through the system, and lightweight options for short-term metrics.
What to monitor on Kubernetes
* Node-level metrics: cluster size, node health, and performance (CPU, memory, network, disk).
* Pod-level metrics: pod counts and per-pod resource usage (CPU, memory).
Collecting, storing, and analyzing metrics requires a solution that:
* Scrapes metrics from nodes and pods,
* Stores metrics (at least temporarily),
* Provides querying/analytics for current and, optionally, historical data.
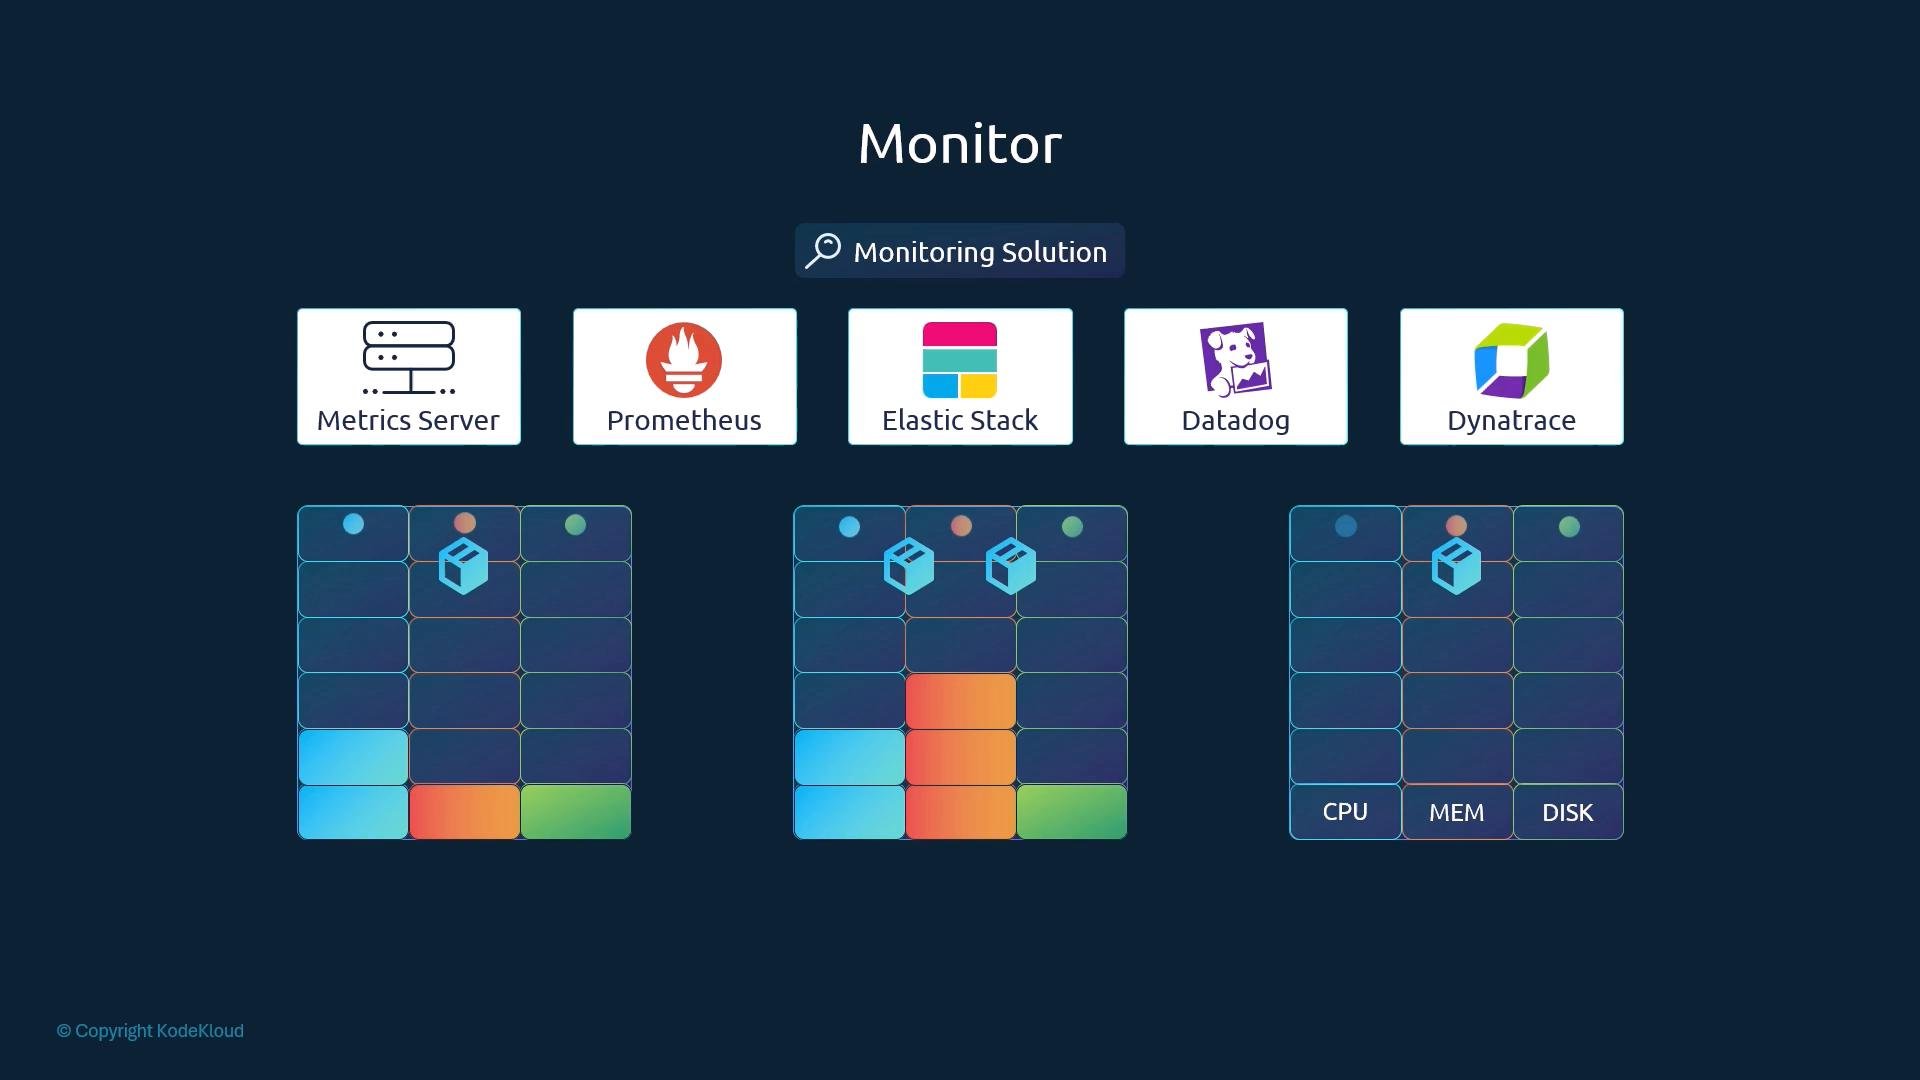
Kubernetes does not ship a full monitoring system by default. Common open-source and commercial options include:
* Metrics Server (lightweight, short-term),
* Prometheus (time-series database and query engine),
* Elastic Stack, Datadog, Dynatrace (commercial/enterprise solutions).
 Historic note: Heapster was previously used to collect cluster metrics but is now deprecated in favor of newer, more focused solutions.
 Heapster is deprecated and should not be used for production monitoring. Replace Heapster-based tooling with Metrics Server for short-term metrics or Prometheus for full time-series monitoring and long-term storage.
What the Metrics Server provides
* One Metrics Server per cluster is typical.
* It scrapes metrics from all kubelets, aggregates them in memory, and serves current cluster metrics.
* It does not persist time-series data to disk, so it cannot provide historical metrics.
Use Metrics Server for lightweight, near-real-time metrics (e.g., `kubectl top`, Horizontal Pod Autoscaler). For historical storage, advanced queries, and alerting, use a Prometheus-based stack or a commercial monitoring service.
How metrics are produced and collected
* kubelet: runs on every node, manages pods, and exposes node/pod metrics.
* cAdvisor: built into kubelet; collects per-container resource usage (CPU, memory, filesystem, network).
* Metrics Server: scrapes the kubelet endpoints across the cluster to gather and aggregate metrics.
Component summary
| Component | Role | Notes / Links |
| - | - | - |
| kubelet | Node agent that manages pods and exposes metrics endpoints | See `kubelet` documentation |
| cAdvisor | Collects per-container resource usage | Exposes metrics via kubelet |
| Metrics Server | Aggregates metrics from kubelets; serves them to kubectl and HPA | `metrics-server` is not long-term storage |
Deploying Metrics Server
* Minikube:
```bash theme={null}
minikube addons enable metrics-server
```
* Other clusters (apply official components):
```bash theme={null}
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml
```
This creates the Metrics Server deployment, service, and RBAC roles required for scraping kubelets and serving aggregated metrics. After deploying, allow a short period for metric collection before querying.
Viewing metrics with kubectl
* Node metrics:
```bash theme={null}
kubectl top node
```
* Pod metrics:
```bash theme={null}
kubectl top pod
```
Example outputs:
```bash theme={null}
$ kubectl top node
NAME CPU(cores) CPU% MEMORY(bytes) MEMORY%
kubemaster 166m 8% 1337Mi 70%
kubenode1 36m 1% 1046Mi 55%
kubenode2 39m 1% 1048Mi 55%
$ kubectl top pod
NAME CPU(cores) CPU% MEMORY(bytes) MEMORY%
nginx 166m 8% 1337Mi 70%
redis 36m 1% 1046Mi 55%
```
Practice exercise
* Deploy Metrics Server in a test cluster (Minikube or a cloud cluster).
* Create a few pods with varying resource limits/requests.
* Use `kubectl top node` and `kubectl top pod` to observe live resource usage.
* If you need historical metrics, set up Prometheus (and optionally a remote storage backend) and compare stored time-series vs Metrics Server live view.
Links and references
* Metrics Server: [https://github.com/kubernetes-sigs/metrics-server](https://github.com/kubernetes-sigs/metrics-server)
* Prometheus: [https://prometheus.io/](https://prometheus.io/)
* Kubernetes concepts: [https://kubernetes.io/docs/concepts/](https://kubernetes.io/docs/concepts/)
* cAdvisor: [https://github.com/google/cadvisor](https://github.com/google/cadvisor)
Practice viewing performance metrics on your Kubernetes cluster to reinforce these concepts.
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.